浏览器原理
1. 事件循环
重要性: 事件循环是浏览器重要的技术之一,如果没有事件循环,浏览器就运行不起来!!!
在事件循环之前,先了解几个知识点
浏览器的进程模型
什么是进程?
程序运行需要有自己专属的内存空间,可以把这块内存空间简单的理解为进程 每个应用至少有一个进程,进程之间相互独立,即使要通信,也需要双方同意. 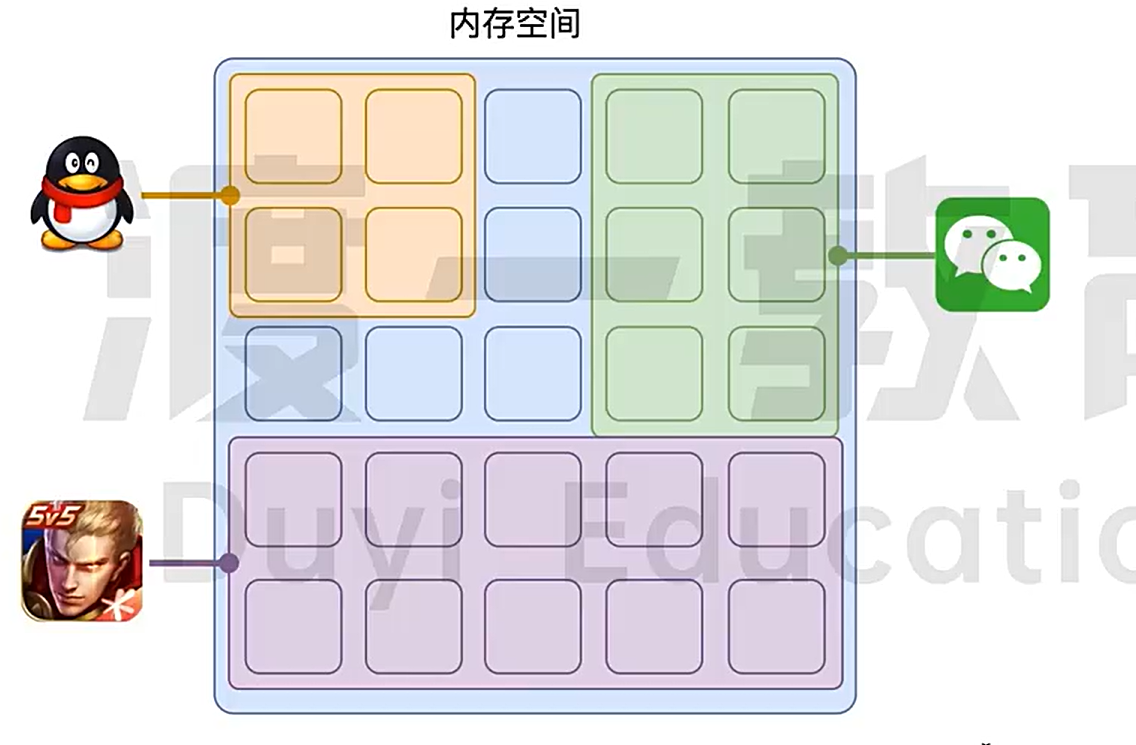
什么是线程?
有了进程之后,就可以运行程序的代码了.
运行代码的人称为线程
一个进程至少有一个线程, 所以在进程开启后会自动创建一个线程来运行代码,该线程称之为主线程
如果程序需要同时执行多块代码,主线程就会启用更多的线程来启动代码,所以一个进程可以包含多个线程
如果一个程序的主线程结束了,那么整个程序就结束了!!
浏览器有哪些进程和线程
浏览器是一个多进程和多线程的应用程序
浏览器内部工作及其复杂
为了避免项目影响, 为了减少连环崩溃的几率,当启动浏览器后,它会自动启动多个进程
浏览器主要有以下几个进程
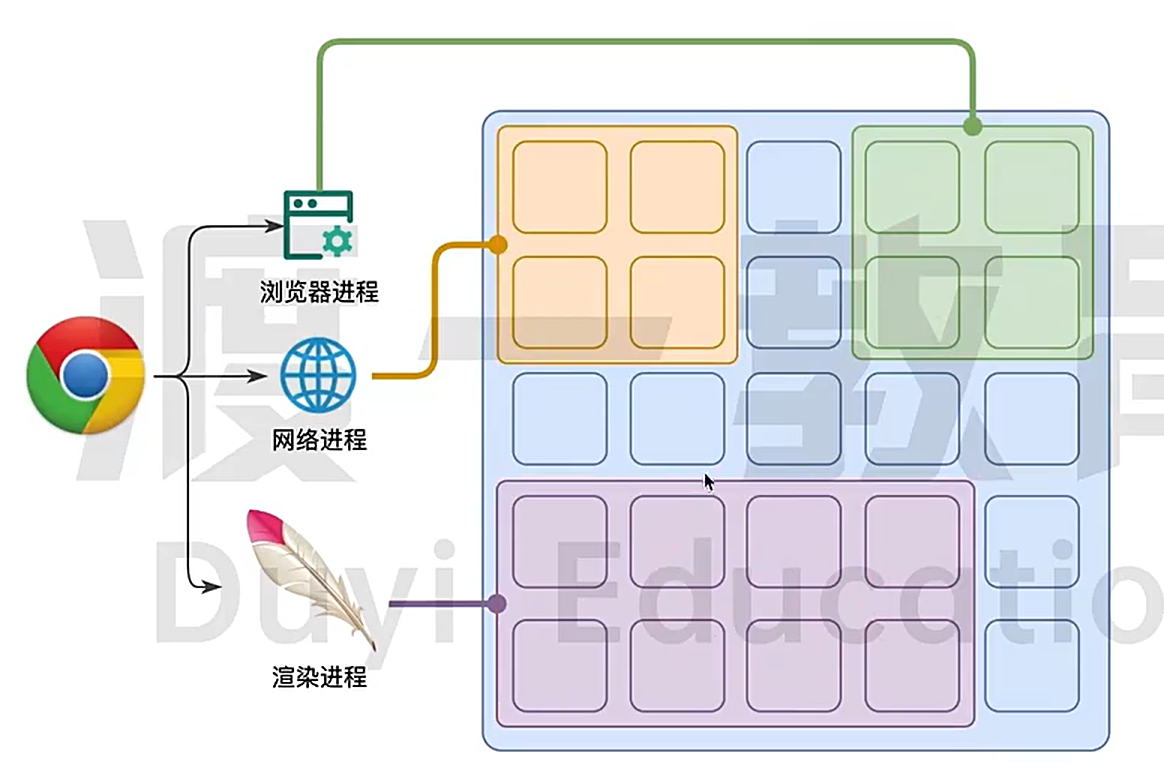
1. 浏览器进程
主要负责界面展示,用户交互,子进程管理等等,浏览器进程内部会启动多个线程处理不同的任务
2. 网络进程
负责加载网络资源。网络进程内部会启动多个线程来处理不同的网络任务
3. 渲染进程(重点)
渲染进程启动后,会开启一个渲染主线程,主要负责执行 HTML, CSS, JS代码.
默认情况下,浏览器会为每个标签页开启一个新的渲染进程,以保证不同的标签页之前不相互影响。
渲染主线程是如何工作的呢?
解析 HTML
解析 CSS
计算样式
布局
处理图层
每秒把页面渲染60次(例如游戏中的FPS)
执行全局JS代码
执行事件处理函数
执行计时器的回调函数
等等...
思考题
为什么渲染进程不适用多个线程来处理这些事情?
要处理这么多的任务,主线程遇到了一个前所未有的难题: 如何调度任务 ?
比如:
我正在执行一个JS函数,执行到了一半的时候用户点击了按钮,我该立即去执行点击事件的处理函数吗?
我正在执行一个JS函数,执行到了一半的时候某个计时器到达了时间,我该立即去执行它的回调嘛?
浏览器通知我"用户点击了按钮", 与此同时,某个计时器也到达了时间,我应该处理哪一个呢?
等等...
渲染主线程想出了一个绝妙的主意: 排队!
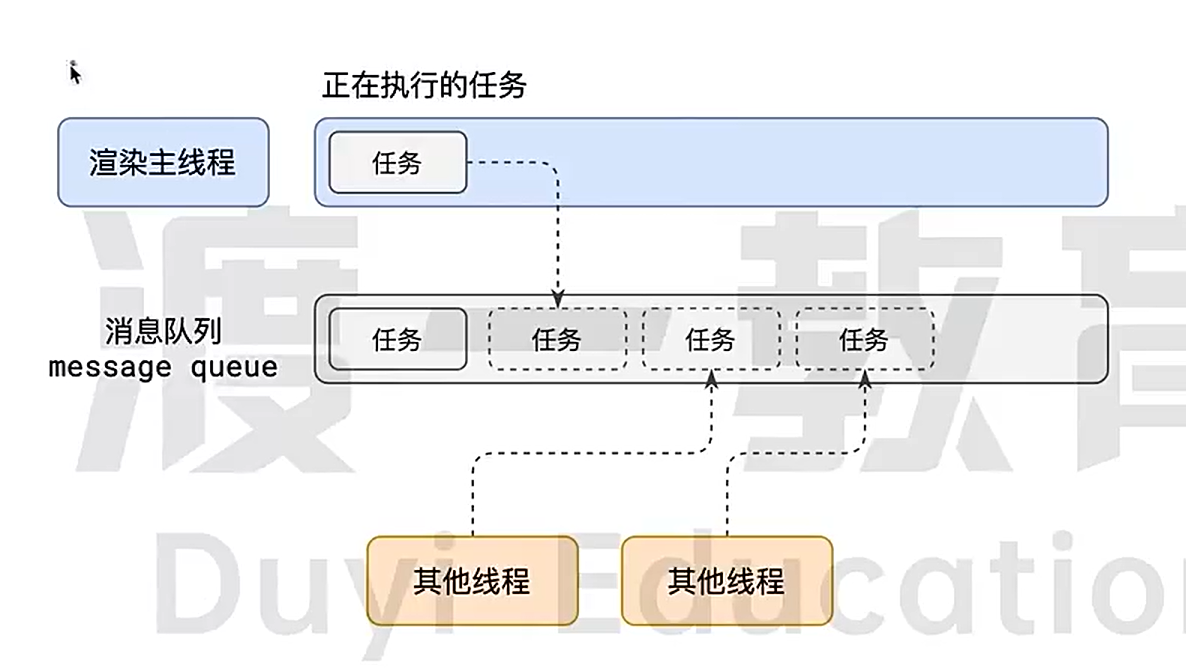
- 在最开始的时候,渲染主线程会进入一个无限循环
- 每一次循环会检查消息队列中是否有任务存在。如果有,就取出第一个任务执行,执行完一个后进入下一次循环;如果没有,则进入休眠状态
- 其他的所有线程(包括其他进程的线程)可以随时向消息队列添加任务。新任务会加到消息队列的末尾。在添加新任务时,如果主线程是休眠状态,则会将其唤醒以继续循环拿取任务
这样一来,就可以让每个任务有条不絮的,持续的进行下去了.
整个过程称之为事件循环(消息循环)
何为异步?
代码在执行过程中, 会遇到一些无法立即处理的任务,比如:
计时完成后需要执行的任务 -- setTimeout,setInterval
网络通信完成后需要执行的任务 -- XHR, Fetch
用户操作后需要执行的任务 -- addEventListener
如果让渲染主线程等待这些任务的时机达到,就会导致主线程长期处于阻塞的状态,从而导致浏览器卡死
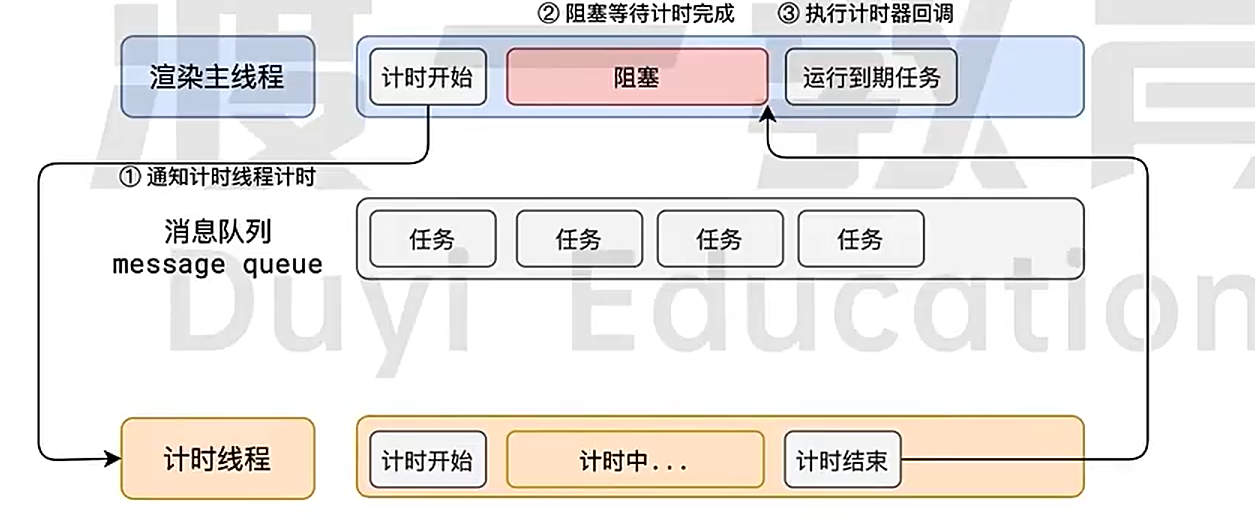
渲染主线程承担着及其重要的工作,无论如何都不能阻塞
因此浏览器选择异步来解决这个问题
接下来我们看一道面试题:
/**
面试题:如何理解 JS 的异步?
参考答案:
JS是一门单线程的语言,这是因为它运行在浏览器的渲染主线程中,而演染主线程只有一个。
而渲染主线程承担着诸多的工作,渲染页面、执行 JS 都在其中运行。如果使用同步的方式,
就极有可能导致主线程产生阻塞,从而导致消息队列中的很多其他任务无法得到执行。这样一
来,一方面会导致繁忙的主线程白白的消耗时间,另一方面导致页面无法及时更新,
给用户造成卡死现象。所以浏览器采用异步的方式来避免。具体做法是当某些任务发生时,
比如计时器、网络、事件监听,主线程将任务交给其他线程去处理,自身立即结束任务的
执行,转而执行后续代码。当其他线程完成时,将事先传递的回调函数包装成任务,
加入到消息队列的末尾排队,等待主线程调度执行。在这种异步模式下,
浏览器永不阻塞,从而最大限度的保证了单线程的流畅运行。
*/
JS为何会阻碍渲染
先看下列代码
<!DOCTYPE html>
<html lang="en">
<head>
	<meta charset="UTF-8">
	<meta name="viewport" content="width=device-width, initial-scale=1.0">
	<title>JS会阻碍页面渲染</title>
</head>
<body>
	<h1>JS会不会阻碍页面渲染</h1>
	<button id="btn">change</button>

	<script>


		// 死循环
		function delay(duration){
			var start = Date.now()
			while(Date.now() - start < duration) {}
		}
		const btn = document.getElementById("btn")
		const h1 = document.querySelector("h1")
		console.log(btn);
		btn.onclick = function(){
			console.log(1111111111)
			h1.textContent = "JS会阻碍页面渲染"
			delay(3000)
		}
	</script>
</body>
</html>
整个js的运行逻辑如下所示: 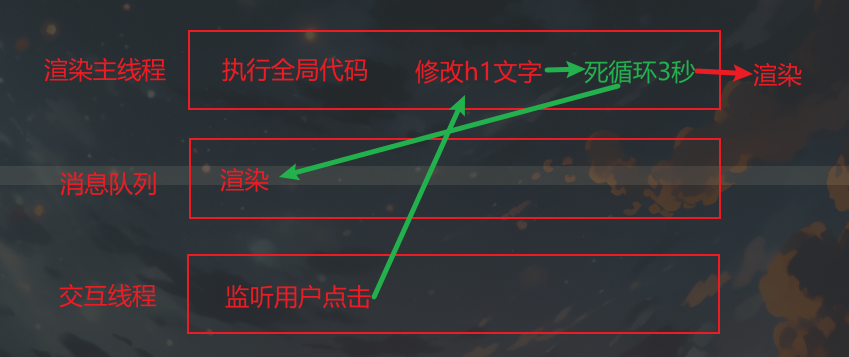
任务有优先级吗?
任务没有优先级,在消息队列中先进先出 但消息队列是有优先级的 根据w3c的最新解释:
- 每个任务都有一个任务类型,同一个类型任务必须在一个队列,不同类型的任务可以分属于不同的队列。在一次事件循环中,浏览器可以根据实际情况从不同的队列中取出任务执行。
- 浏览器必须准备好一个微队列,微队列中的任务优先所有其他任务执行
在目前chrome的实现中,至少包含了下面的队列:
- 延时队列: 用户存放计时器到达后的回调任务,优先级:中
- 交互队列: 用户存放用户操作后的事件处理任务,优先级:高
- 微队列: 用户存放需要最快执行的任务,优先级: 最高
添加任务到微队列的主要方式主要是使用Promise,MutationObserver
面试题阐述一下JS的事件循环
/** 事件循环又叫做消息循环,是浏览器渲染主线程的工作方式。在 chrome 的源码中,
 * 它开启一个不会结束的 for 循环,每次循环从消息队列中取出第一个任务执行,
 * 而其他线程只需要在合适的时候将任务加入到队列末尾即可。过去把消息队列简单分为
 * 宏队列和微队列,这种说法目前已无法满足复杂的浏览器环境,取而代之的是一种更加
 * 灵活多变的处理方式。根据 W3C 官方的解释,每个任务有不同的类型,同类型的任务
 * 必须在同一个队列,不同的任务可以属于不同的队列。不同任务队列有不同的优先级,
 * 在一次事件循环中,由浏览器自行决定取哪一个队列的任务。但浏览器必须有一个微队
 * 列,微队列的任务一定具有最高的优先级,必须优先调度执行。*/
JS中的计时器能做到精准计时嘛
    /**
     * JS做不到精准计时,主要有一下几点原因:
     * 1. 计算机硬件没有原子钟,无法做到精准计时
     * 2. 操作系统的计时函数本身就有少量的误差,js的计时器最终调用的是操作系统的函数,也就携带了这些偏差
     * 3. 按照w3c的标准,浏览器实现计时器时,如果嵌套层级超过5层,则会带有4毫秒的最少时间,这样在计时时间少于4毫秒时又带来了误差
     * 4. 受事件循环的影响,计时器的回调函数只能在渲染主线程空闲时运行,因此又带来了误差
     */
两句话总结事件循环
1. 单线程是异步产生的原因
2. 事件循环是异步的实现方式
2.浏览器的渲染原理
浏览器的渲染原理我们从下面这道面试开始看
当我们在浏览器中输入url发生了什么
当我们在浏览器中输入url后,主要有两方面: 一方面是网络方面,另一方面就是渲染。 我们这一部分主要学习渲染方面,看下面的图片 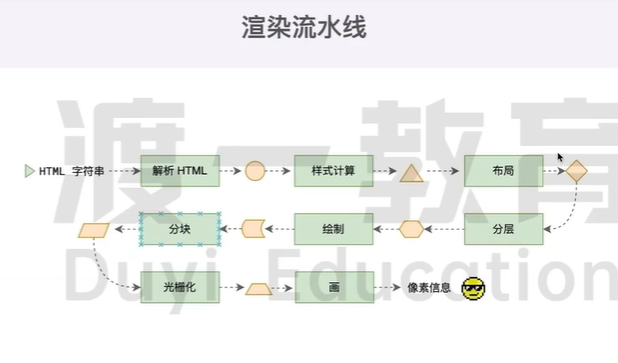
第一步 解析HTML
解析HTML主要的是为了生成DOM树和CSSOM树 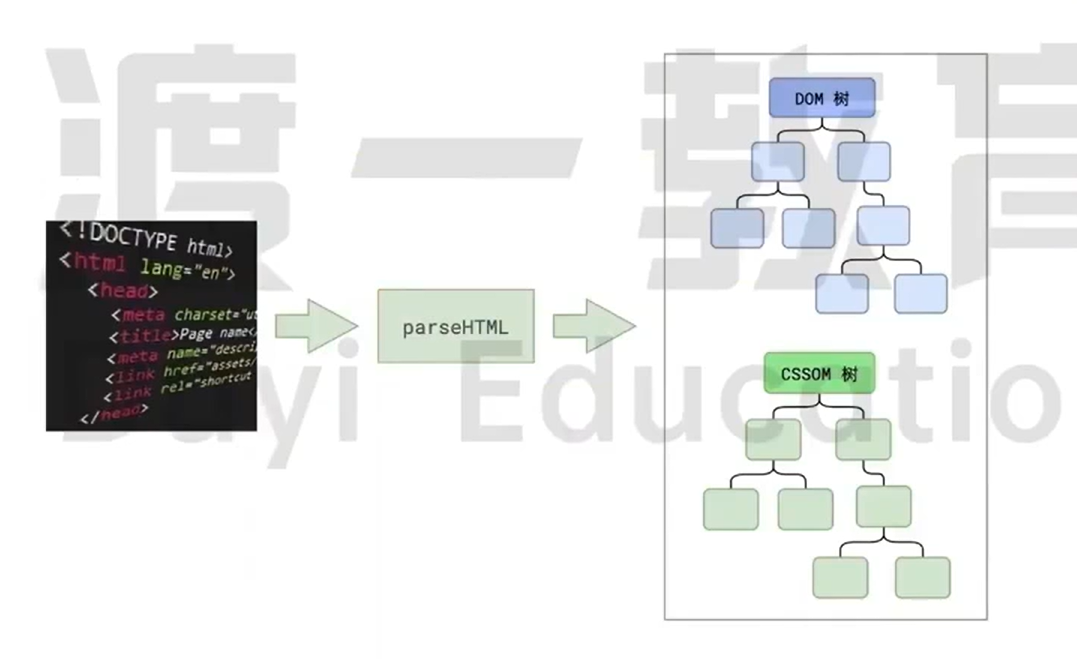
当我们输入浏览器后,拿到的是一个字符串,通过解析这个字符串得到DOM,SOM树。
DOM树应该很好理解吧,这里就不说了,我们来说说SOM树 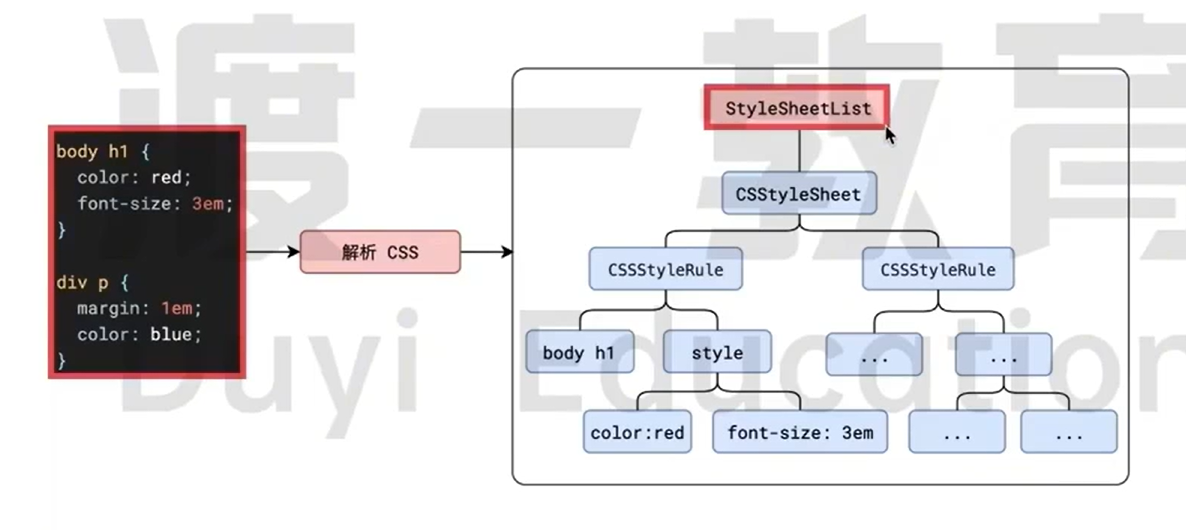
在浏览器中提供了4种样式表: 1.浏览器的默认样式表;2.外部样式表;3.行内样式表;4.<style></style>
除了浏览器的默认样式表,我们都可以修改。通常我们修改的都是行内样式表,但是我们可以通过document.styleSheets[0].addRule来修改其他的样式表
如果解析过程种遇到css代码该怎么办呢?
请看下面的图 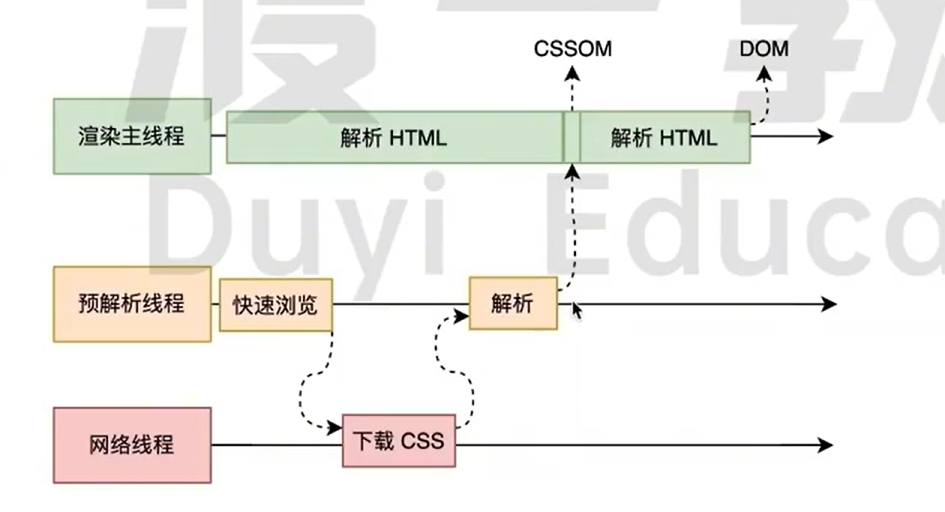 渲染主线程会自动开启一个预解析线程,解析css,但是最终的SOM树还是由渲染主线程组成的. 这也是css不会阻塞HTML解析的根本原因,css的解析是在予解析线程里进行的所以不会阻塞HTML解析
如果遇到js代码呢?
渲染主线程在遇到<script></script>标签后,会暂停html的解析,转而等待JS文件下载完成,执行完js的全局代码,才继续解析HTML.这是因为 JS在执行的过程中可能会改变当前的DOM树,所以DOM树的生成必须暂停。这就是JS会阻塞HTML的根本原因。 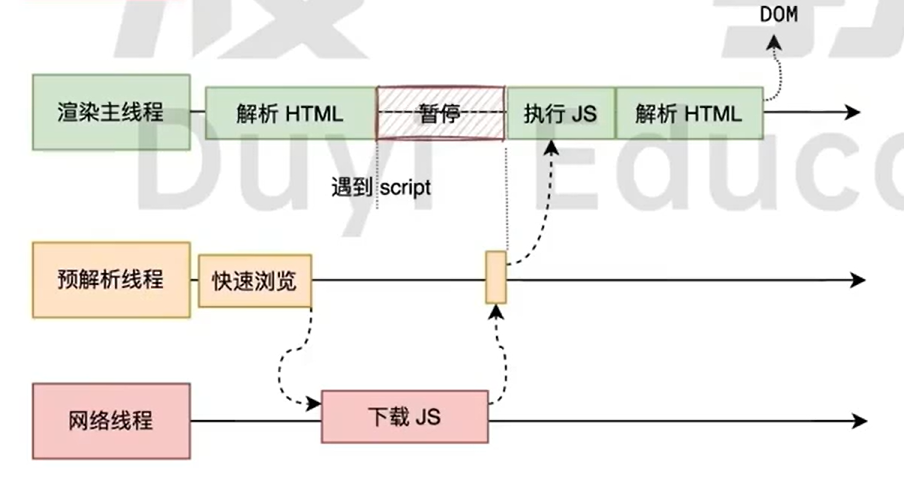
第二步 样式计算
这一部分包含2个css重要的部分
- css属性的计算过程(层叠,继承等)
- 视觉格式化模型(盒模型,包含块等)
这部分主要是干什么呢?
主线程会遍历DOM树, 依次为树中的每个节点计算出它最终的样式,在这一过程中,很多预设值会变成绝对值,比如red会变成rgb(255,0,0);相对单位会变成绝对单位,比如em会变成px
这一步完成后,会得到一颗带有样式的DOM树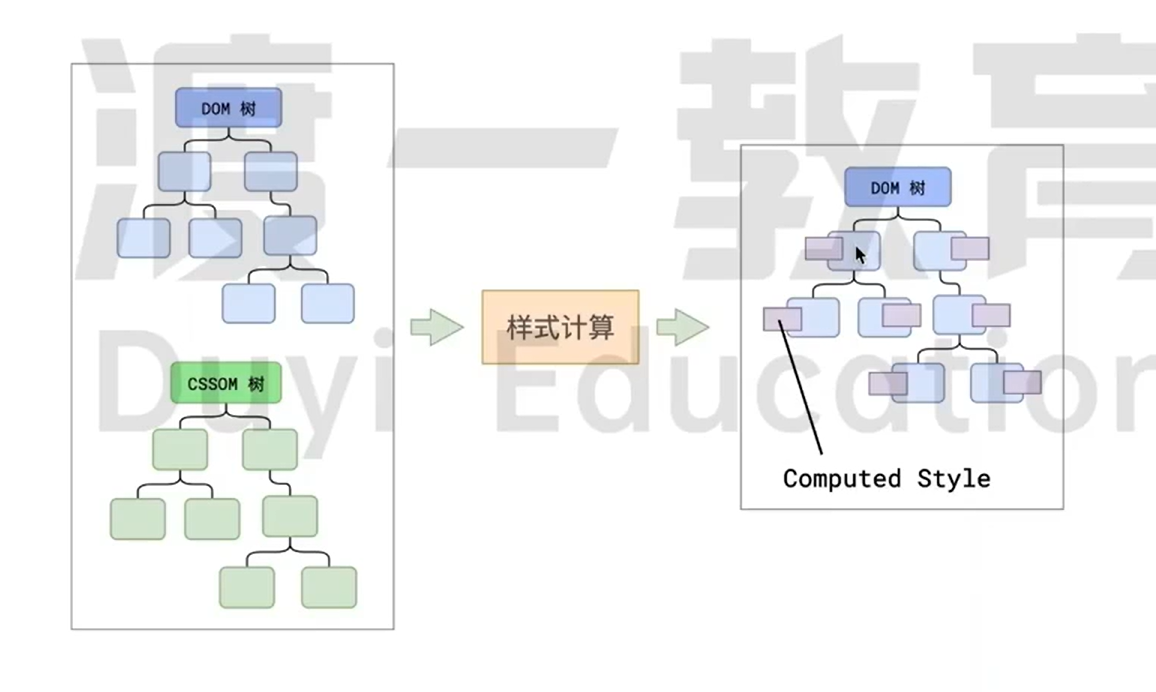
第三步 布局
这一步将计算出来的DOM树生成一个布局树,这里需要注意的是,布局树和DOM树是不一样的,比如display: none的元素不会在布局树上 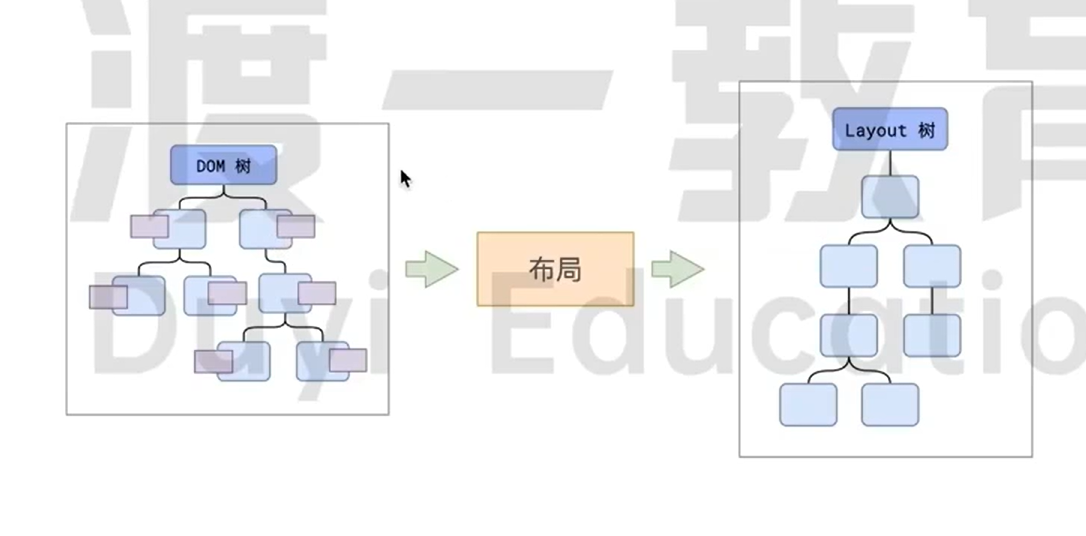 这里有一个重要的规则:
- 内容必须在行盒中
- 行盒和块盒不能相邻
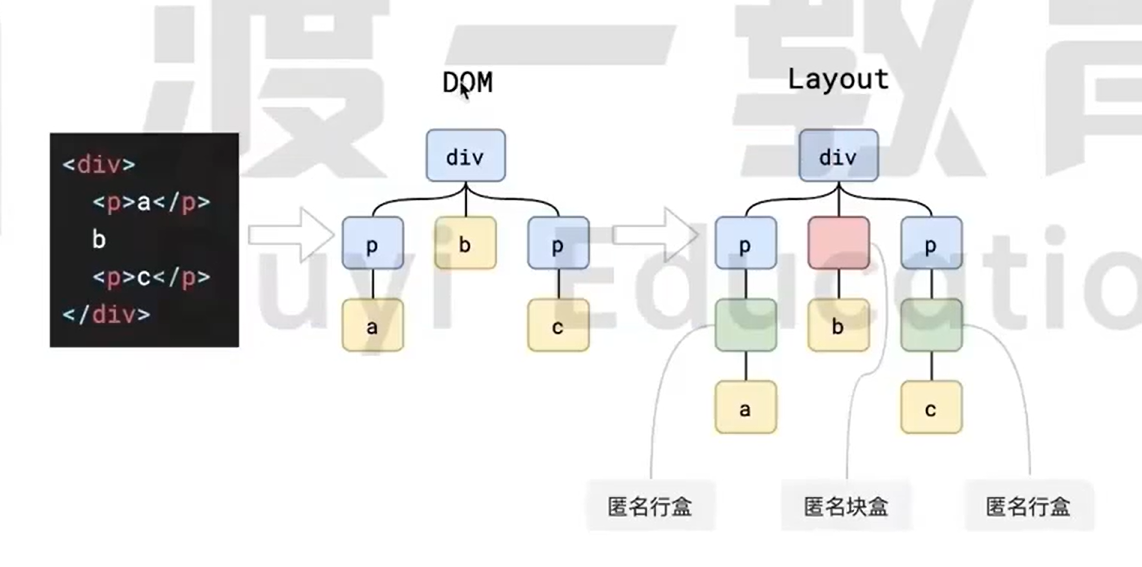 当内容在块盒中时,布局树会自动生成一个块盒放在其中
当行盒和块盒相邻时,布局树会自动将行盒外层包裹一层块盒
这里有一个重要的概念包含块
我们通过一个题来理解这个包含块
<!DOCTYPE html>
<html lang="en">
<head>
	<meta charset="UTF-8">
	<meta name="viewport" content="width=device-width, initial-scale=1.0">
	<title>包含块</title>
</head>
<style>
	.container{
		width: 500px;
		height: 500px;
        border: 10px;
        box-sizing: border-box;
		background: #bfa;
	}

	a{
		width: 300px;
	}

	img{
		width: 100%;
	}
</style>
<body>
	<div class="container">
		<a href="">
			<img src="/images/bg.png" loading="lazy" alt="">
		</a>
	</div>
</body>
</html>
请问图片的宽度是多少 ?
正确答案: 480px
包含块是离该元素最近的祖先块盒
第四步 分层
主线程会是使用一套复杂的策略对布局树进行分层
分层的好处在于,将来在一个层改变后,仅会对该层进行后续处理,从而提高效率。
滚动条,堆叠上下文,transform,opacity等样式都会或多或少影响分层的结果,也可以通过will-change属性更大程度的影响分层的结果。
第五步 绘制
主线程会为每个层单独的产生绘制指令集,用于描述这一层的内容该如何画出来,主线程的工作到此为止,剩余的步骤交给其他线程完成。
第六步 分块
分块会将每一层分为多个小的区域,分块的工作是合成线程从线程池中拿出多个线程同时进行的 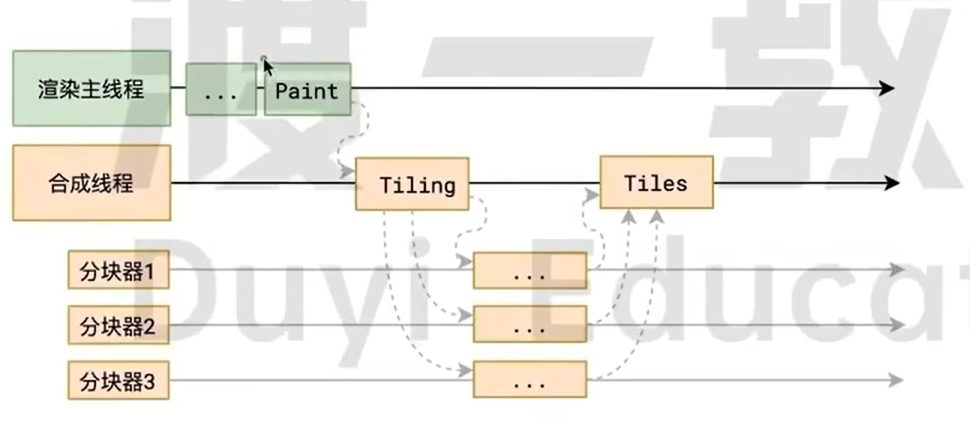
第七步 光栅化(Raster)
光栅化是将每个块变成位图
合成线程会将块信息交给GPU进程,以极高的速度完成光栅化。
GPU进程就会开启 多个线程来完成光栅化,并且优先处理靠近视口区域的块。
光栅化的结果,就是一块一块的位图
光栅化也算是优化的一种,太多的工作要做,优先处理掉靠近视口区域的块
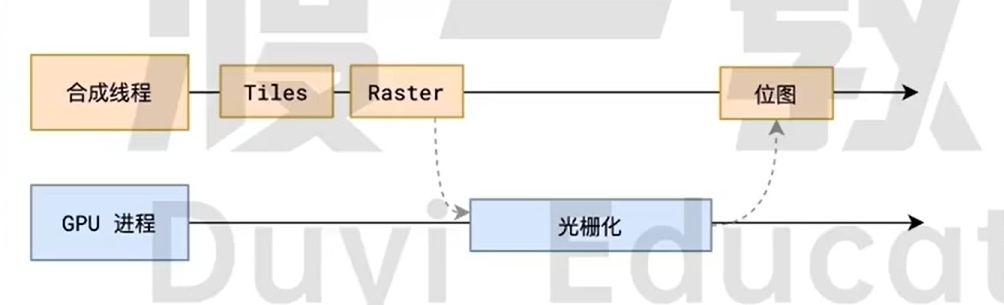
此过程会用到GPU加速(可以提升光栅化的速度)
第八步 画
合成线程计算出每个位图在屏幕上的位置,交给GPU进行最终呈现。 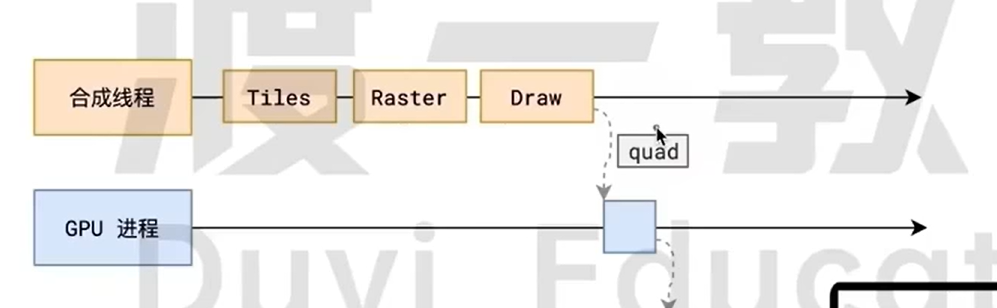
合成线程拿到每个层,每个块的位图后,生成一个个指引信息。 指引会标识出每个位图应该画到屏幕的哪个位置,以及会考虑到旋转,缩放等变形。 变形发生在合成线程,与渲染主线程无关,这就是transform效率高的本质原因。 合成线程会把quad提交给GPU进程,由GPU进程产生系统调用,提交给CPU硬件,完成最终屏幕成像。
这就是渲染的整个过程
下面我们思考几个问题?什么是reflow?
reflow的本质就是重新计算layout树。
当进行了会影响布局树的操作后,需要重新计算布局树,会引发layout。 为了避免连续的多次操作导致布局树反复计算,浏览器会合并这些操作,当JS代码全部完成后再进行统一计算。 所以,改动属性造成的reflow是异步完成的。
也同样因为如此, 当JS获取布局属性时,就可能造成无法获取到最新的布局信息。 浏览器在反复权衡下,最终决定获取属性立即reflow。
什么是repaint?
repaint的本质就是根据分层信息计算了绘制指令
当改动了可见样式后,就需要重新计算,会引发repaint。
由于元素的布局信息也属于可见样式,所以reflow一定会引起repaint。
为什么transform的效率高?
我们来看下面的代码
<!DOCTYPE html>
<html lang="en">
<head>
	<meta charset="UTF-8">
	<meta name="viewport" content="width=device-width, initial-scale=1.0">
	<title>Document</title>
	<style>
		*,.container{
			margin: 0;
			padding: 0;
		}

		.top{
			width: 200px;
			height: 200px;
			border-radius: 50%;
			background: red;
			margin-top: 100px;
			animation: move1 1s alternate infinite ease-in-out;
		}

		.bottom{
			width: 200px;
			height: 200px;
			border-radius: 50%;
			background: red;
			position: absolute;
			top:50%;
			animation: move2 1s alternate infinite ease-in-out;
			transition: left 1s;
			left: 0;
		}

		#btn{
			margin-top: 80px;
			margin-left: 100px;
		}


		@keyframes move1 {
			to{
				transform: translate(100px);
			}
		}

		@keyframes move2 {
			to{
				left: 100px;
			}
		}
	</style>
</head>
<body>
	<div class="container">
		<button id="btn">死循环</button>
		<div class="top"></div>
		<div class="bottom"></div>
	</div>
	<script>
		let btn = document.getElementById("btn")
		btn.onclick= function(){
			delay(3000)
			}

		function delay(duration){
			const start = Date.now()
			while(Date.now() - start < duration){}
		}
	</script>
</body>
</html>
当点击死循环时,页面卡死,但是transform的小球动画还在动,为什么呢? 因为渲染主线程卡死,但是transform不在渲染主线程中。
3.浏览器的缓存策略
浏览器的缓存是浏览器在本地磁盘对用户最近请求过的文档进行存储,当访问者再次访问同一个页面时,浏览器就可以直接从本地磁盘加载文档
浏览器是如何判断是否使用缓存的?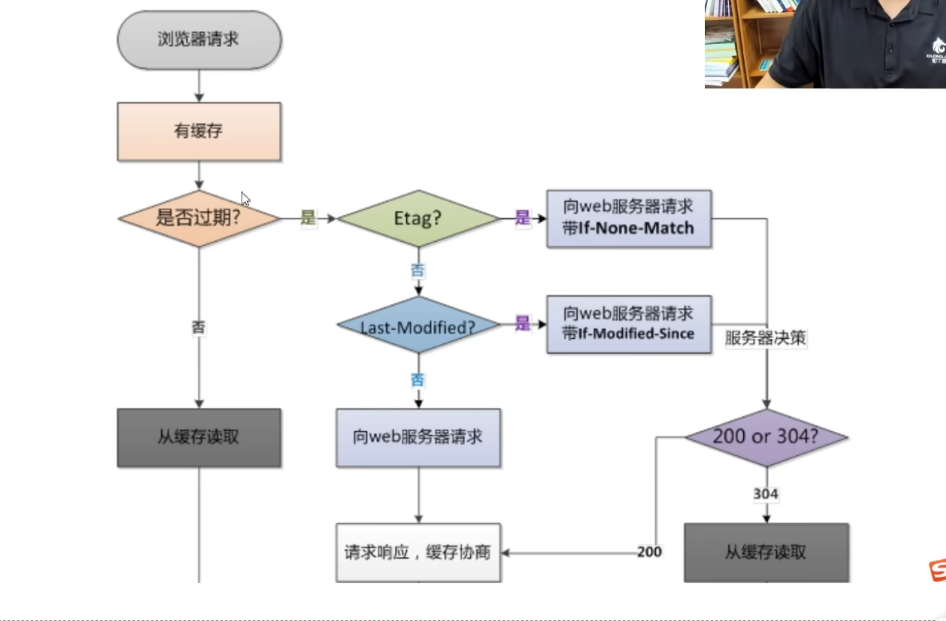
浏览器缓存的优点:
- 减少了冗余的数据传输, 节省了网费
- 减少了服务器的负担, 大大提高了网站的性能
- 加快了客户端加载网页的速度
浏览器的缓存主要有两类: 缓存协商和彻底缓存,也有称之为协商缓存和强缓存
- 强制缓存: 不会向服务器发送请求,直接在缓存中读取资源,在chrome控制台的network选项中可以看到该请求返回200的状态码
- 协商缓存: 在使用本地缓存之前,需要向服务器发送请求,服务器会根据这个请求的request header的一些参数来判断是否命中协商缓存,如果命中,则返回304状态码并带上新的response header通知浏览器从缓存中读取资源;协商缓存可以解决强制缓存的情况下,资源不更新的问题
两者的共同点: 都是从客户端缓存中读取资源,区别是强缓存不会发请求,协商缓存会发请求
强制缓存中header的参数:
Expires: 过期时间,如果浏览器再次加载资源时,在这个过期时间内,则命中强缓存
Cache-control: 当值设为max-age=300时,则代表在这个请求正确返回时间(浏览器也会记录下来) 的5分钟内再次加载资源,就会命中强缓存
Cache-control除了该字段外,还有下面几个比较常用的设置值:
-no-cache: 不使用本地缓存。需要使用协商缓存,先与服务器确认返回的响应是否被更改,如果之前的响应中存在ETag,那么请求的时候会与服务端验证,如果资源未被更改,则可以避免重新下载
-no-store: 直接禁止浏览器缓存数据, 每次用户请求该资源,都会向服务器发送一个请求,每次都会下载完整的资源
-pulic: 可以被所有的用户缓存,包括终端用户和CDN等中间代理服务器。
-private: 只能被终端用户的浏览器缓存,不允许CDN等中继缓存服务器对其缓存
Expires: 设置以分钟为单位的绝对过期时间,设置相对过期时间,max-age指明以秒为单位的缓存时间
Expires优先级比Cache-Control低,同时设置Expires和Cache-Control则后者生效
协商缓存中header的参数
设置协商缓存: cache-control: -no-cache
Last-Modify/if-Modify-Since: 浏览器第一次请求一个资源时,服务器返回的header中会加上Last-Modify, Last-Modify 是一个时间标识该资源的最后修改时间;当浏览器再次请求该资源时, request的请求头中会包含if-Modify-Since, 该值为缓存之前返回的Last-Modify。服务器收到 If-Modify-Since后,根据资源的最后修改时间判断是否命中缓存。
Last-Modify的值是资源最后修改的值
ETag/If-None-Match: web服务器响应请求时,告诉浏览器当前资源在服务器的唯一标识(生成规则由服务器决定)。If-None-Match: 发现资源具有ETag声明,则再次向web服务器请求时带上头If-None-Match(Etag的值)。web服务器收到请求后发现有头If-None-Match则与被请求资源的相应校验串进行比对,决定是否命中协商缓存;
Etag的值是文件对应的hash值(但是会加大服务器开销,这个hash是需要生成的)
ETag和Last-Modified的作用和用法,它们的区别:
- Etag要优于Last-Modyfied.Last-Modified的时间单位是秒,如果某个文件在1秒内改变了多次,那么他们的Last-Modified其实并没有体现出来修改,但是Etag每次都会改变确保了精度。
- 在性能上,Etag要逊于Last-Modyfied, 毕竟Last-Modified只需要记录时间,而Etag需要服务器通过算法来计算出一个hash值。
Vue源码部分
1. Vue的数据双向绑定
- Vue处理数据的流程
1.数据拦截(只要是操作的数据,都会被拦截)
2.观察者模式(观察数据的变化)
3.数据解析(将和指令解析成js对象,通过diff算法将js对象转换成Dom对象,最后将dom对象展示在页面上)
- Vue采用什么进行数据拦截?
Vue2.X采用ES5的Object.defineProperty()
Vue3.X采用ES6新增的Proxy类
- Vue3为什么用"Proxy"取代"Object.defineProperty"
Vue2响应式的核心就是通过Object.defineProperty()转换成get和set,当获取和修改时会触发响应式,但是 动态添加和删除时并不会触发响应式,并且数组的下标获取也不会触发。所以Vue3使用Proxy代理重写了响应式系统
Vue2的数据双向绑定
<!DOCTYPE html>
<html lang="en">
<head>
    <meta charset="UTF-8">
    <meta name="viewport" content="width=device-width, initial-scale=1.0">
    <title>Document</title>
</head>
<body>
    <script>

        /**
         * 单个属性
         * */
        let obj = {
            name: "孙悟空",
            age: 18
        }

        let _name = obj.name // 防止栈溢出
        Object.defineProperty(obj,"name",{
            get:function() {
                console.log("name被获取")
                return _name
            },
            set:function(newVal) {
                console.log("name被修改")
                _name = newVal
            }
        })

        console.log(obj.name)
        obj.name="猪八戒"

    </script>
</body>
</html> <!DOCTYPE html>
<html lang="en">
<head>
<meta charset="UTF-8">
<meta name="viewport" content="width=device-width, initial-scale=1.0">
<title>Document</title>
</head>
<body>
<script>
/**
* 所有的属性
* */
let obj = {
name: "孙悟空",
age: 18
}
for (const key in obj) {
_key = obj[key]
Object.defineProperty(obj,key,{
get(){
console.log(`属性${key}被获取了`)
return _key
},
set(newVal) {
console.log(`属性${key}被修改了`)
_key = newVal
}
})
}
console.log(obj.age)
obj.age = 20
console.log(obj.age)
</script>
</body>
</html>